¿Realmente hemos llegado a utilizar BDD? El Renacimiento de Gherkin en Haka Automation Engine
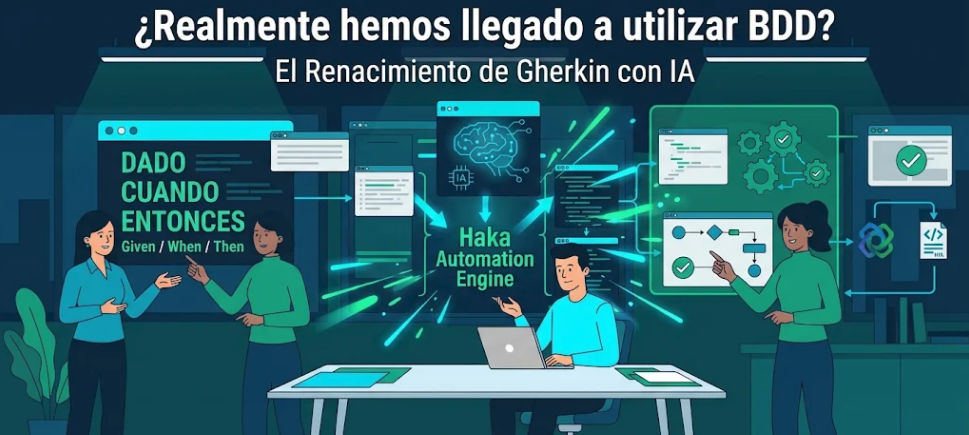
Gherkin nació dentro del ecosistema de Cucumber, impulsado por la evolución del Desarrollo Guiado por Comportamiento (Behavior-Driven Development o BDD), una propuesta que tomó fuerza a mediados de la década de 2000 de la mano de Dan North y otros referentes de la comunidad de desarrollo. Su propósito era bastante claro: resolver la brecha de comunicación entre el negocio y la ingeniería de software.
Retrocedamos un poco. ¿Qué es el BDD?
Concebido como una evolución de TDD (Test-Driven Development), BDD proponía que el diseño y la comprensión de los sistemas debían surgir de conversaciones estructuradas entre los tres amigos (Three Amigos: producto, desarrollo y testing). Para materializar estas conversaciones en especificaciones que pudieran ser entendidas tanto por personas como por herramientas de automatización, se popularizó la estructura Dado / Cuando / Entonces (Given / When / Then), que posteriormente se convirtió en una de las principales características del ecosistema Cucumber. Su propósito no era simplemente programar pruebas automatizadas de interfaz, sino definir especificaciones ejecutables que permitieran describir y validar el comportamiento esperado de un sistema antes y durante su desarrollo. Entonces (y resumiendo bastante)...
BDD: Es un enfoque de desarrollo donde el comportamiento funcional de los requerimientos se describe mediante ejemplos concretos, utilizando un lenguaje común que facilite el entendimiento entre negocio, desarrollo y calidad.
Gherkin: Es un lenguaje de dominio específico (Domain Specific Language o DSL) que permite representar esos comportamientos mediante una sintaxis estructurada y legible. Incluye palabras clave como Given (Dado), When (Cuando), Then (Entonces), And (Y) y Feature (Característica), entre otras.
Cucumber / Behave: Son herramientas y frameworks que permiten interpretar archivos .feature escritos en Gherkin y vincular sus pasos con implementaciones de código que permiten ejecutar los escenarios.
Es importante señalar una confusión común cuando se mencionan los orígenes del BDD. Si bien se considera una evolución de TDD, sus objetivos no son exactamente los mismos. TDD plantea un ciclo de desarrollo donde primero se escribe una prueba que falla y luego se implementa el código necesario para hacerla pasar. BDD, en cambio, busca algo más general: entregar contexto funcional mediante la descripción de comportamientos y ejemplos que permitan entender qué debe hacer un sistema y cómo debería responder ante determinadas situaciones. En este sentido, BDD no exige necesariamente construir pruebas automatizadas antes de comenzar el desarrollo, sino establecer una comprensión compartida de los comportamientos esperados. Esto permite entregar información en un lenguaje común, entendible tanto por negocio, desarrollo y calidad.
Ejemplo de un escenario en Gherkin
Escenario: Login exitoso en intranet
  Dado que estoy en el home de la intranet
  Y completo correctamente el nombre de usuario con "[email protected]"
  Y completo correctamente el password
  Cuando presiono el botón enviar
  Entonces el sistema me redirige al sitio interno "/mi-perfil"
Como ves, esto describe de forma simple lo que debería suceder en un login sin ningún tipo de problema. Sin embargo, es solo uno de decenas de posibles escenarios que se pueden plantear para una funcionalidad de este tipo. Para hacerlo de forma robusta necesitamos describir a detalle la mayoría de los posibles flujos: correo incorrecto o vacío, dominio no permitido, formato inválido, contraseña ausente o incorrecta, intento de login sin datos, con datos parciales, etc.
Esta necesidad de especificar y mantener tantos escenarios creo que fue uno de los motivos que dificultaron la adopción de BDD tal como se había pensado originalmente. Y aquí no nos vamos a engañar a nosotros mismos: uno de los puntos débiles en el desarrollo de software siempre fue la documentación. Ahora, con la IA, mágicamente tenemos más documentación, pero eso no significa necesariamente que tengamos mejor documentación o que alguien esté revisando lo que se genera.
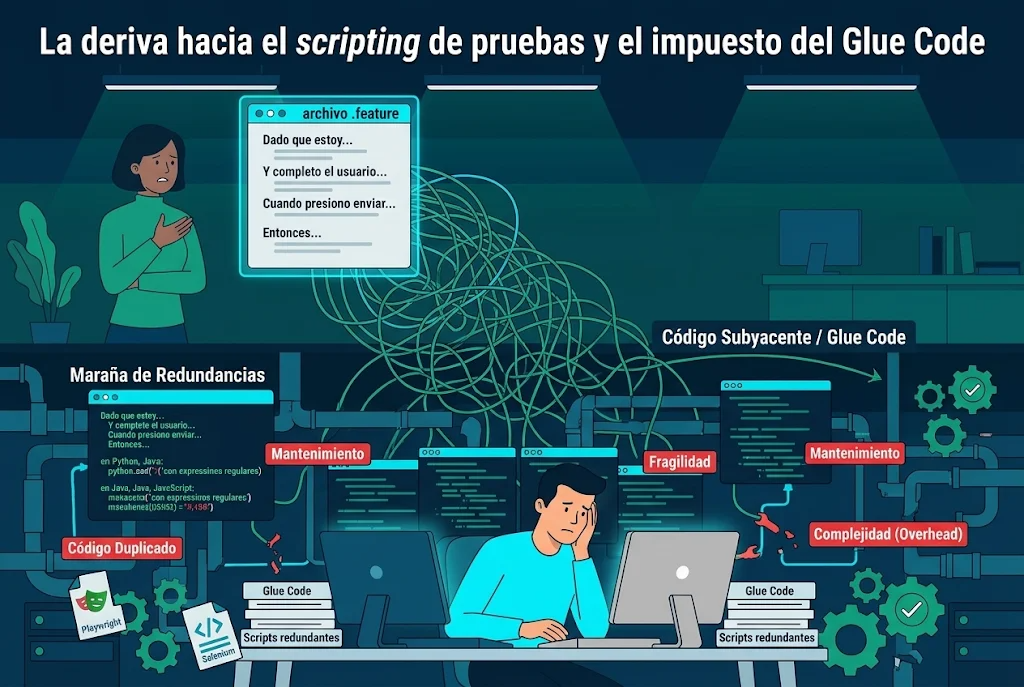
1. La deriva hacia el scripting de pruebas y el impuesto del Glue Code
Con el paso de los años, la visión colaborativa original de Gherkin fue perdiendo protagonismo en buena parte de las implementaciones de la industria. Muchos equipos comenzaron a utilizar los archivos .feature principalmente desde las áreas de QA, dejando en segundo plano su función como herramienta de conversación, especificación y diseño entre negocio y desarrollo. Gherkin pasó, sin querer, de ser una herramienta para describir comportamientos a convertirse en un lenguaje de scripting para automatizadores, y BDD una metodología que promovemos, pero que muy difícilmente aplicamos en toda su dimensión.
Esta deriva introdujo una paradoja técnica y una importante carga de mantenimiento:
1. La ilusión de la simplicidad: Un archivo .feature parece accesible para perfiles no técnicos, pero cada paso escrito en lenguaje natural necesita una implementación de código subyacente (step definitions o glue code) en Python, Java, JavaScript o C#. Es decir, lo que parece una instrucción sencilla para cualquier persona termina dependiendo de una implementación que requiere conocimientos técnicos.
2. La trampa de la duplicación: En la práctica habitual, cada equipo de automatización termina construyendo su propia infraestructura para resolver problemas que otros equipos ya resolvieron muchas veces: interpretar expresiones, manejar sincronizaciones contra el navegador, gestionar esperas dinámicas, interactuar con elementos y trabajar con librerías como Selenium o Playwright. A esto se suma que, cuando no existen convenciones claras, aparecen múltiples implementaciones para realizar exactamente la misma operación.
3. Fragilidad y mantenimiento: El acoplamiento entre la descripción en lenguaje natural y la lógica interna puede volverse frágil. Pequeñas inconsistencias semánticas generan pasos duplicados con implementaciones diferentes, y el mantenimiento del glue code termina consumiendo una parte importante del tiempo que debería dedicarse al diseño funcional de las pruebas. Esto es especialmente problemático cuando no hay convenciones claras sobre cómo utilizar Gherkin, creando situaciones donde encontramos pasos como: «Y doy clic en el botón», «Y doy clic en el botón aceptar», «Y doy clic en el botón aceptar nuevo», etc.
El resultado es que muchos equipos terminan considerando Gherkin como una capa redundante de complejidad innecesaria (overhead sintáctico) por encima del código de automatización. Y esto es bastante contradictorio, porque una herramienta que nació para facilitar la comunicación termina introduciendo más trabajo técnico para poder utilizarla.
2. El dilema de la automatización en la era de los modelos de lenguaje
La irrupción de los Modelos de Lenguaje (LLMs) prometió transformar radicalmente el testing de software. Ahora podemos solicitar a una IA que analice una aplicación, identifique funcionalidades y genere escenarios o incluso scripts completos de automatización. Sin embargo, delegar la generación completa de pruebas a una inteligencia artificial también plantea retos importantes de fiabilidad, mantenimiento y escalabilidad.
Veamos algunos de ellos:
Alucinación de selectores e implementaciones: Si le pedimos a un LLM generar código directamente (por ejemplo, scripts completos en Playwright o Selenium), el modelo puede inventar localizadores DOM, asumir eventos que no existen o utilizar elementos que no corresponden con la estructura real de la aplicación. También puede omitir sincronizaciones necesarias o implementar esperas que no contemplan las condiciones reales de ejecución.
Falta de consistencia: La naturaleza probabilística de los LLMs hace que, ante una misma tarea, puedan generar implementaciones diferentes. Aunque ambas parezcan correctas, pueden resolver el mismo problema utilizando estrategias distintas, dificultando la estandarización, la legibilidad y el mantenimiento del código en entornos de integración continua (CI/CD).
El problema del Glue Code asistido por IA: Si un agente de IA escribe escenarios en Gherkin convencional y también debe desarrollar sus respectivos step definitions, estamos trasladando a la IA los mismos problemas que históricamente han tenido los equipos de automatización. El modelo puede introducir fallos de sincronización, malas prácticas de aserción, duplicación de pasos o lógica difícil de mantener.
No se trata de que la IA no pueda generar buenas automatizaciones. De hecho, puede hacerlo. El problema es que generar código funcional no es lo mismo que construir una infraestructura de automatización mantenible, reutilizable y controlada.
Para que la IA sea verdaderamente efectiva en automatización, necesita trabajar dentro de un espacio de acción delimitado, con capacidades conocidas, contratos claros y una ejecución controlada. En otras palabras, no siempre necesitamos que la IA invente cómo hacer algo; muchas veces necesitamos que sepa qué puede hacer y cómo utilizarlo correctamente.
3. El replanteamiento de HakaLab: Gherkin como interfaz declarativa para la automatización
En HakaLab replanteamos el rol de Gherkin a través de Haka Automation Engine (haka-playwright-engine). En lugar de tratar a Gherkin como una plantilla en blanco que exige escribir código de soporte en cada proyecto, lo transformamos en una interfaz declarativa respaldada por un motor de ejecución preconstruido.
La idea es bastante sencilla: si la mayoría de las automatizaciones necesitan resolver operaciones técnicas similares, ¿por qué tenemos que volver a programarlas en cada proyecto?
El framework combina Playwright y Behave, integrando un catálogo que supera los 2.000 pasos estandarizados que resuelven internamente buena parte de la lógica técnica necesaria para ejecutar una automatización.
Entre sus principales características encontramos:
Resolución estandarizada de la lógica de ejecución: Los pasos preconstruidos manejan de forma nativa operaciones como la espera de elementos, manipulación avanzada del DOM, eventos de teclado y ratón, gestión de ventanas, almacenamiento local y aserciones suaves (soft assertions). El automatizador o la IA no necesitan programar desde cero la mecánica del clic, el scroll o la sincronización de cada interacción.
Separación de localizadores mediante Page Objects en JSON: Los selectores no necesitan estar incrustados directamente en los pasos ni en código imperativo. Se organizan de forma desacoplada en archivos JSON, permitiendo centralizar su mantenimiento y reducir el acoplamiento entre los escenarios funcionales y la estructura interna de las aplicaciones.
Amplitud de automatización sin fragmentación de herramientas: El catálogo no se limita a navegación web. Sobre una misma base de trabajo permite cubrir pruebas de API REST, Salesforce, automatización móvil mediante Appium, aplicaciones de escritorio y SAP mediante OCR/OpenCV, además de incorporar capacidades para la validación de sistemas de IA generativa, incluyendo similitud semántica, evaluación de respuestas, detección de alucinaciones y análisis de sesgos.
Ejecución y gestión de escenarios: Soporta ejecución concurrente, mecanismos de bloqueo de recursos compartidos (filelocks), parametrización avanzada mediante Scenario Outlines, integración con Jira/Xray y utilización de variables dinámicas para la generación de datos.
La diferencia es que ya no necesitamos desarrollar una implementación técnica para cada paso que queremos utilizar. Podemos concentrarnos en describir el comportamiento que necesitamos validar y dejar que el motor resuelva las operaciones correspondientes.
Veamos un ejemplo:
Característica: Gestión de flujos de negocio

  Como analista de QA o agente inteligente
  Quiero orquestar pasos estandarizados
  Para validar el sistema sin programar el andamiaje técnico

  Escenario: Validación de autenticación y consulta transaccional
    Dado que navego a la URL base del sistema
    Cuando ingreso el texto dinámico "{usuario_valido}" en el campo "login.input_email"
    Y hago clic en el botón "login.btn_continuar"
    Y completo el formulario de seguridad con simulación humana
    Entonces el elemento "dashboard.tabla_saldos" debe ser visible dentro de 5 segundos
En este esquema, los pasos utilizados no necesitan implementar nuevamente la lógica de interacción. El motor ya conoce cómo resolverlos y los localizadores se encuentran desacoplados en el Page Object correspondiente. De esta manera, el archivo .feature recupera un rol mucho más cercano a su propósito original: describir de forma legible los comportamientos que queremos validar, sin tener que incorporar en cada escenario los detalles técnicos de su ejecución.
Y aquí es donde aparece una oportunidad bastante interesante cuando incorporamos inteligencia artificial.
4. MCP: Gherkin como espacio de acción para agentes de IA
La evolución decisiva de esta arquitectura radica en la integración del Model Context Protocol (MCP) mediante nuestro servidor propio haka-mcp.
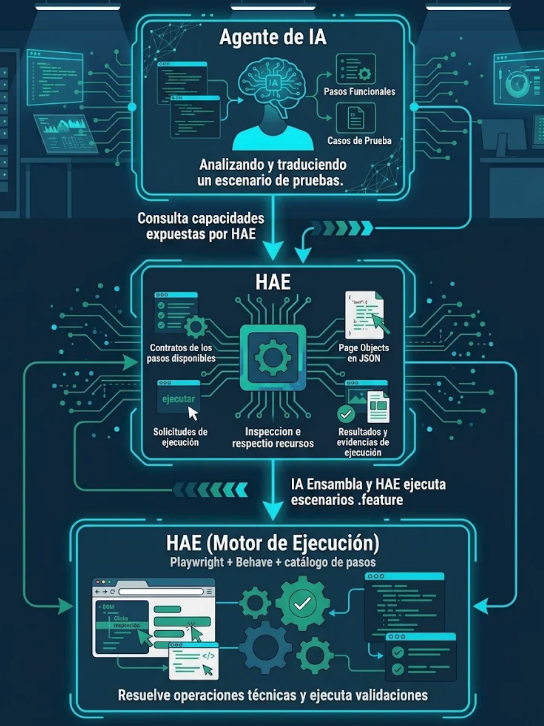
MCP es un protocolo que permite estandarizar la comunicación entre aplicaciones de IA y herramientas externas. En nuestro caso, permite exponer las capacidades de Haka Automation Engine para que asistentes y agentes inteligentes puedan descubrirlas, consultarlas y utilizarlas sin necesidad de conocer cómo están implementadas internamente.
Esto cambia bastante la forma en que podemos abordar la generación de automatizaciones.
Pensemos en asistentes como Claude Desktop, Cursor, Kiro AWS o nuestro propio Koru, el asistente integrado en nuestro Haka Automation IDE. En lugar de pedirles que generen un script completo de Playwright, podemos permitirles consultar qué operaciones están disponibles, qué parámetros necesitan y cómo utilizarlas.
La arquitectura funciona de la siguiente manera:
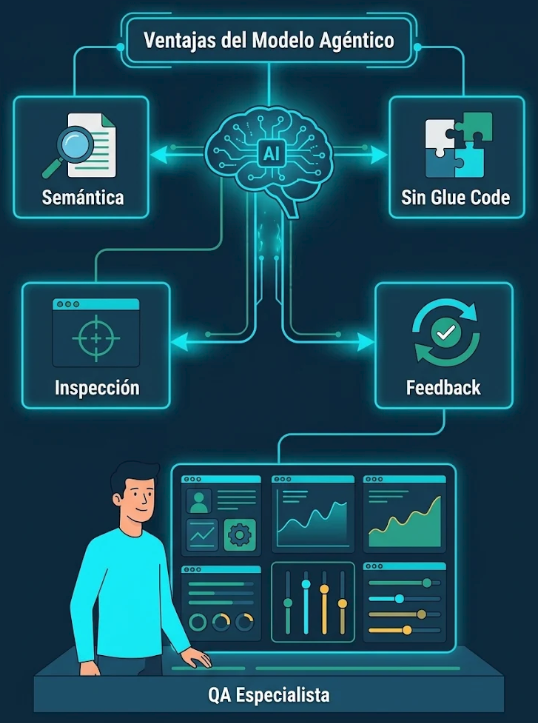
¿Qué ventajas tiene este modelo agéntico?
1. Uso de pasos conociendo únicamente su descripción: La IA no necesita inspeccionar implementaciones en Python ni escribir código para interactuar con la pantalla. A través de MCP puede consultar las descripciones semánticas de los pasos disponibles, identificar el localizador correspondiente en el JSON POM y redactar el archivo .feature utilizando las capacidades existentes. Y al utilizar nuestro Haka Agentic IDE, nos desprendemos de la necesidad de utilizar MCP, en su lugar el IDE utiliza semantica 100% para encontrar los steps disponibles para resolver las necesidades de los flujos automatizados, esto permite mayor presición.
2. Eliminación del andamiaje técnico redundante: Se reduce considerablemente la necesidad de que la IA genere glue code desde cero. El modelo deja de gastar recursos intentando inferir cómo programar un drag-and-drop, cómo capturar una respuesta JSON o cómo gestionar una sincronización con el navegador. Su rol se concentra en interpretar el comportamiento esperado, seleccionar las operaciones disponibles y orquestar el flujo funcional.
3. Inspección de aplicaciones y construcción de escenarios: Mediante las capacidades de navegación e inspección disponibles en el ecosistema, un agente puede interactuar con una aplicación real, identificar elementos, obtener selectores y utilizar esa información para estructurar escenarios funcionales. Esto permite pasar de una descripción inicial del comportamiento a una automatización que utiliza localizadores y operaciones disponibles en el motor.
4. Ejecución y retroalimentación: Una vez construido el escenario, el agente puede solicitar su ejecución mediante behave directo, usando los Runners del IDE o del HAE e inclusive mediante MCP. El motor procesa los pasos, ejecuta las validaciones y devuelve los resultados y evidencias correspondientes. Si la prueba falla, el agente puede analizar la información recibida, identificar posibles inconsistencias y proponer ajustes al escenario.
Es importante aclarar algo: Ni el uso de nuestro Haka Agentic IDE, ni el MCP interno del HAE puede garantizar por sí mismos que un agente autonomo construya escenarios correctos ni que seleccione siempre la operación adecuada. Esa responsabilidad sigue dependiendo del modelo, del contexto disponible, de la calidad de las especificaciones y del QA especialista, quien resuelta ser siempre el salva guarda de calidad interno en la construcción de los escenarios. Lo que sí conseguimos con esta arquitectura es delimitar las capacidades que puede utilizar, reducir la generación de código innecesario y establecer una base de ejecución mucho más controlada y reutilizable.
5. La convergencia del ciclo de vida
Si observamos la evolución de BDD, podemos encontrar tres momentos bastante diferentes en la forma de entender y utilizar Gherkin:
El camino recorrido por Gherkin cierra así un círculo bastante interesante. Concebido originalmente para que las personas pudieran expresar la intención del software sin enredarse en detalles técnicos, hoy encuentra en la inteligencia artificial un nuevo interlocutor.
Pero creo que el verdadero cambio no está en que ahora una IA pueda escribir archivos .feature. Eso ya era posible y, por sí solo, no resuelve ninguno de los problemas que hemos mencionado anteriormente.
El cambio está en cómo conectamos esa intención con la ejecución. Al disponer de un catálogo de capacidades estandarizadas, un motor que resuelve las operaciones técnicas y la forma en que el HAE las expone mediante documentación, semántica, IDE y MCP, Gherkin puede recuperar su valor como interfaz declarativa entre quienes definen los comportamientos y quienes, o mejor dicho, aquello que los ejecuta.
En HakaLab estamos trabajando precisamente en esa dirección: transformar lo que durante años fue una sintaxis de pruebas que muchas veces terminó sobrecargada de mantenimiento en una capa de comunicación y orquestación entre humanos, automatización e inteligencia artificial.
Quizás el verdadero renacimiento de BDD no consista en volver a utilizarlo exactamente como fue concebido, sino en aprovechar su idea original de una forma que hoy, gracias a la IA y a arquitecturas como Haka Automation Engine, podemos llevar bastante más lejos.